互聯網科技數據設計背景與互聯網數據服務 架構、挑戰與未來
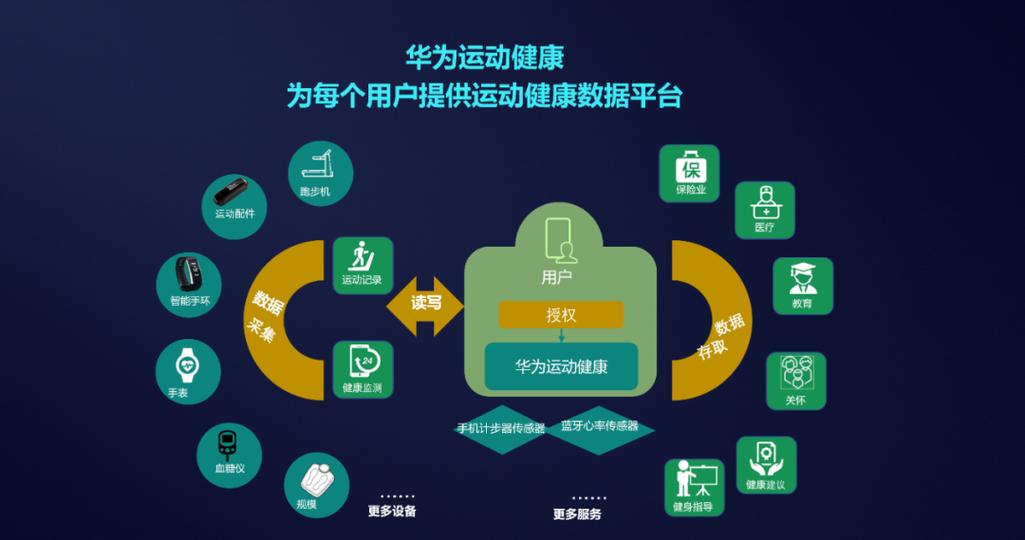
一、引言\n\n21世紀以來,互聯網從信息傳播工具演變為承載社會經濟運行的基礎設施。每一天,全球有數十億用戶在各種平臺上產生搜索、點擊、交易、社交、定位、支付等行為,這些行為持續不斷地被轉化為數據。海量、多樣、高速的數據,構成了互聯網科技的底層“原材料”。與此對應的,是把原始數據加工為可用資產的能力——互聯網數據服務體系。本文圍繞“設計背景”與“數據服務”兩條主線,討論互聯網科技數據體系為何形成、其結構包含什么、面臨怎樣的技術挑戰以及未來將走向何處。\n\n## 二、互聯網科技數據復雜化與數據價值凸顯\n\n互聯網科技數據設計的背景與中國互聯網產業自身的演化緊密相連。最早的網頁時代,數據以靜態HTML和鏈接結構為主,規模和復雜度有限;Web 2.0階段用戶生成內容爆發,UGC成為主要數據源;移動互聯網階段帶來位置的連續移動、社交、音視頻、攝像頭、傳感器,使數據規模產生指數級增長;如今,大模型預訓練、多模態交互和智能推薦依賴的更大規模的模型參數和全生命周期數據管道則進一步完善“大數據+算法驅動”?的數據組織方式,相應標準如采集口徑、可信溯源、價值指標體系、質量評價也應運而生。與此同時:數據自身存在多個復雜型方面:數據源往往是異構和相對孤立的系統(如線下監控、真實業務ERP),一條記錄數據的生命周期既有失效缺陷收集也可能出現在合規受限約束里被迫約束的區域維度分析場景,管理過程中不可避免地出現越權升級(例如schema變更延遲模型判斷敏感變化沖突環節誤判),而如沒有可用統一的字段服務把原本分散來源實時整體衡量風險,對應的用戶產品活躍態勢也難以讓及時響動的靈活性保持在可觀測正確區間范圍內部。“所以這倒逼技術的分析從現實生產源頭深入到資源信息分布式聚合治理及數據結構輕計算范式迭代形成適合這些結構化及不完整隨機稀疏模式下隨機場景兼顧模型推理連續性避免算法隱藏極端個別異常發生影響到整體安全技術”。至此\
更新時間:2026-11-11 03:03:33
如若轉載,請注明出處:http://www.xbuv.cn/product/38.html